SQLiteが壊れたと思ったら、AI開発が止まった。本当の原因と復旧設計
結論から言うと、SQLiteファイルの物理的な破損は確認されていません。2026年10月10日、AI開発の進行管理を担うAIアシスタントのクラウド環境で、タスク管理用SQLiteを参照できなくなりました。ところが、本来は「状態を見るだけ」のコマンドが、新しい空のSQLiteを作成し得る設計だったため、障害の把握がさらに難しくなりました。
問題を深刻にしたのは、その後です。終了したか不明な処理を二重実行しないための安全停止が、無関係な開発にも広がりました。これは「SQLiteは使ってはいけない」という話ではなく、消える可能性がある実行状態を、どう検知し、どう安全に復旧するかという設計の話です。
この記事は当日のIssue・PR・ソースコード・実行記録を突き合わせてまとめた技術的な事後分析です。クラウド提供者がファイルを削除した、SQLiteが内部破損した、といった未確認事項は断定しません。
1. 何が起きたのか:32件から8件へ
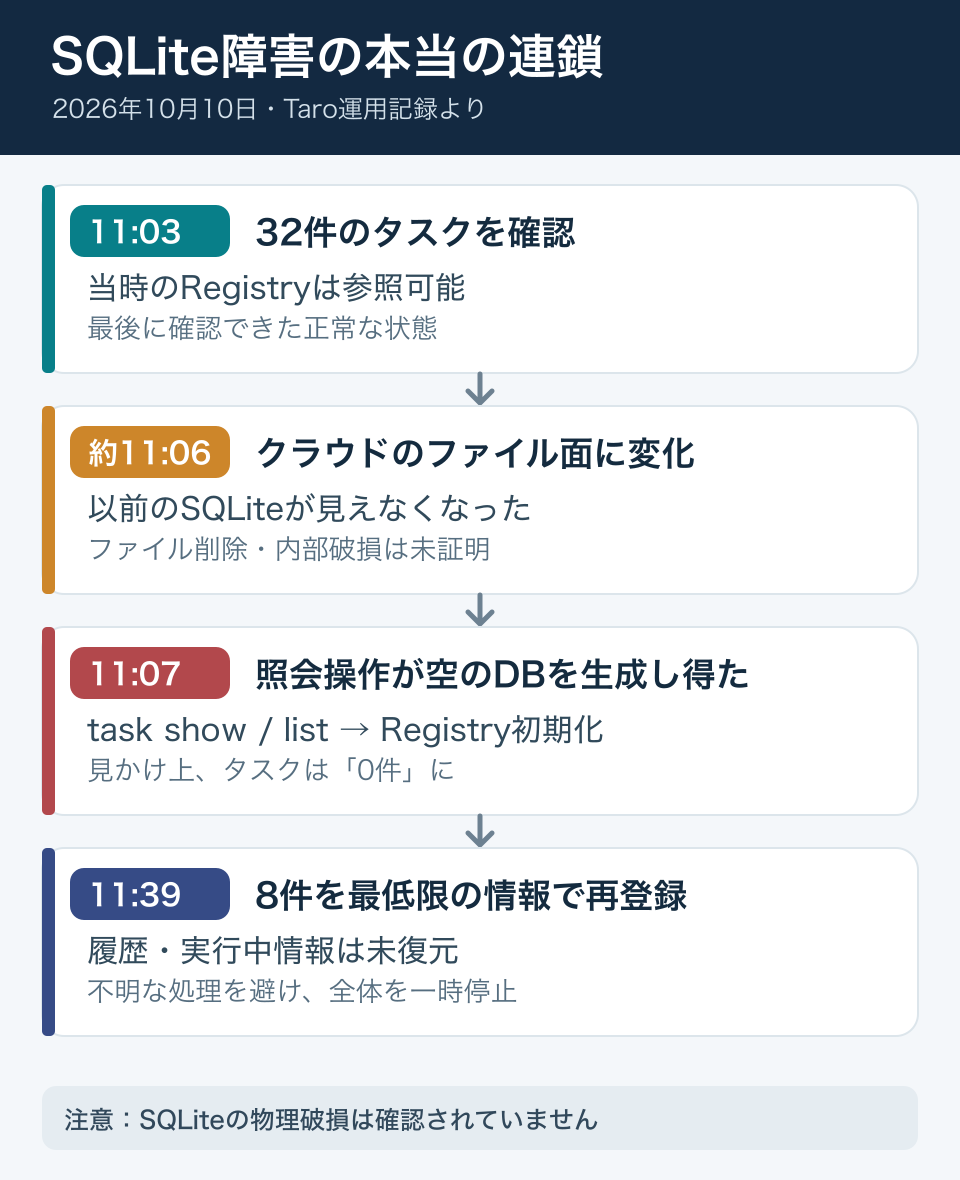
10月10日11:00〜11:03(日本時間):当時のSQLite Registryには32件のタスクがあり、読み取り可能でした。これはその時点の最終正常記録であり、その後も同じファイルが使える保証ではありません。
11:06頃:クラウド作業領域のファイル作成時刻がまとまって変わり、以前の作業用ファイルが見つからなくなりました。実行環境のファイル面が切り替わった可能性が高い一方、何が切り替えを引き起こしたかは不明です。
11:07:従来のタスクを表示できず、一覧も空になりました。この時刻付近に新しいSQLiteファイルが作成されていたことが記録されています。
11:26〜11:39:GitHub上の記録を頼りに、まず1件、その後8件の管理情報を復元しました。同時に、未確認の外部処理を重複起動しないため、全体停止を設定しました。
ここで重要なのは、「8件を復旧した」=「以前の32件の状態を復元した」ではないことです。実行履歴、依存関係、承認状態、外部ワーカーの稼働状況まで戻ったわけではありません。一方、開発の成果物やIssue・PRが管理されていたGitHub自体の消失は確認されていません。
2. 空のSQLiteを作った可能性がある「読み取り」
当時のCLIには、通常のtask showやtask listでタスク管理オブジェクトを生成すると、その初期化処理が親ディレクトリとデータベースの初期化も実行する経路がありました。つまり、DBがなくなっていないか確かめるための操作が、なかったDBを新しく作ってしまい得るのです。
task list / task show
    ↓
Registry を開く
    ↓
親ディレクトリを作る
    ↓
SQLite を初期化する
    ↓
DB が欠けていれば空のファイルができ得るPythonのsqlite3.connect()は通常、指定したDBが存在しなければ作成します。SQLiteには、存在しないファイルを作成せず失敗させる読み取り専用モードもあります。運用監視では、後者のように「見つからない」をそのまま観測できる設計が必要です。
なお、AIアシスタントには読み取り専用の安全な監督経路もありました。しかし、一部の通常CLIコマンドが自動初期化する実装だったことが問題です。初期化された新しいDBに対して整合性チェックが通っても、失われた業務状態が完全だとは証明できません。
3. なぜ開発全体が止まったのか
AIエージェントの開発では、GitHubのコードだけ見ても「別のAIが今まさに同じファイルを書いていないか」は分かりません。実行開始記録、担当ワーカー、対象リソース、実行完了の証拠が必要です。
今回、一部の比較処理には最終的な実行ID・終了状態・後片付けの確認がありませんでした。その処理を未確認のままもう一度起動すると、二重書き込みや衝突を招く可能性があります。したがって、当該処理の再実行を止めた判断には合理性がありました。
しかし安全停止を全体に適用した結果、別のファイル・別のタスクで、競合しないことを証明できる作業まで新規実行できなくなったのです。実際、12:36〜12:41にはGitHub上で独立した読み取り専用レビューを進められたのに、12:52時点でも新たな開発実行は停止状態でした。
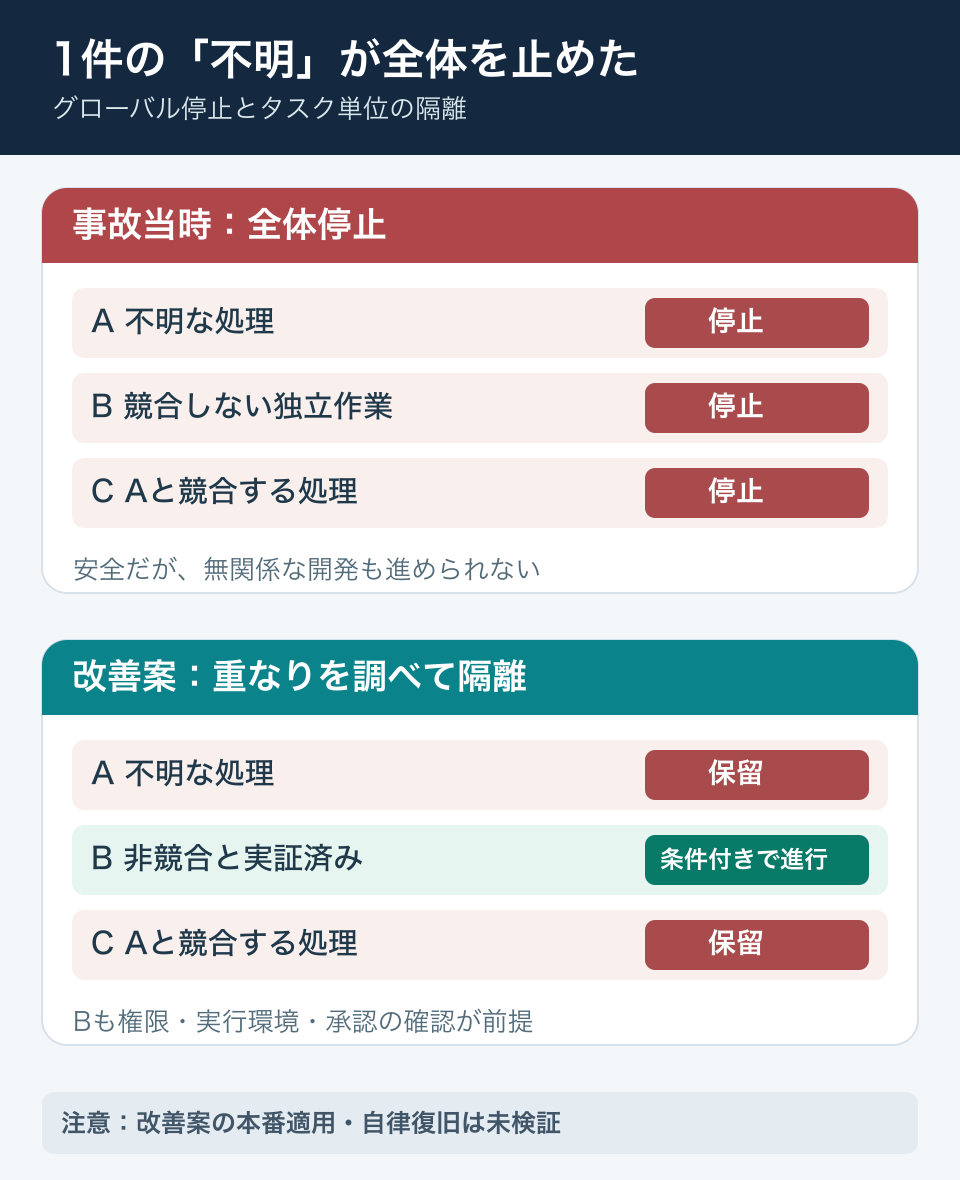
障害復旧で守るべき原則は「不明な作業を安全と決めつけない」ことです。ただし「一件でも不明なら、何もできない」と同義にする必要はありません。影響範囲と実行環境を正しく把握できた独立作業まで止めるのは、過剰な停止です。
4. 原因を4層に分解する
- 症状:タスク一覧が空になり、実行の引き継ぎができなくなった。
- 直接の仕組み:クラウド上で旧DBにアクセスできず、通常の照会経路が空のDBを生成し得た。
- 設計上の弱点:一時的なRegistryに実行状態が集まり、外部実行の確定証拠が十分には残っていなかった。全体停止も独立タスクを識別できなかった。
- 残る未解明点:ファイル面が変化したプラットフォーム側のきっかけ、元DBの物理的な所在、未確認ワーカーの厳密な終了時刻。
原因を「SQLiteが壊れた」の一言で済ませると、読み取りと作成を分離する修正も、実行記録の保存も、タスクごとの安全な隔離も見逃します。
5. GitHubを正本にすれば十分か
このプロジェクトでは、Issue・PR・コード・レビュー結果をGitHubで管理し、SQLiteを実行中の一時的なタスク台帳として扱っていました。障害後は、古い32件のSQLite履歴をすべて復元するのではなく、GitHub上の最新証拠から必要な作業を再判断する方針へ移行しました。
ただし「SQLiteを捨ててGitHubだけ使う」だけで同時実行の問題が解決するわけではありません。Issueのラベルや担当者変更は、外部AIワーカーに対する原子的なロックではありません。GitHub Actionsのconcurrencyも、GitHub Actionsのジョブを制御するもので、別のクラウドAIやMac上のプロセスを直接停止する機能ではありません。
現実的なのは、GitHubを長期の正本にし、実際の外部ワーカーの証拠と照合しながら、タスクの担当・対象ファイル・実行状態を都度検証する方法です。どうしても並列実行を増やすなら、排他制御を実際に強制できる実行経路が必要です。
6. その後の修正と、まだ完了していないこと
10月10日には、不明なタスクと競合するリソースを個別に保留し、独立作業を進められるようにする修正コードがレビュー・テストを経てGitHubへ取り込まれました。10月11日には、GitHubなどの証拠から次に取れる行動を判定する処理も取り込まれました。
しかしソースコードの完成・単体テストの成功と、クラウド実行環境への適用・定期実行による自律復旧は別です。10月11日17時台の確認では、GitHub中心の判断処理は限定的な合成・読み取り専用検証までで、保存済みの監督設定や、実際に人の介入なしで開発が進む一連の動作は未検証でした。さらに、外部作業環境の作成失敗や書き込み側の安全チェック拒否という別の障害も残っています。SQLiteをなくすだけで解決したとは言えません。
7. 同じ事故を防ぐための設計チェック
- 読む操作では絶対にDBを作らない。ファイルの存在、実行環境、パスを副作用なく確認し、欠損時は明示的に停止する。
- 仕事の正本と、一時的な実行状態を分離する。Issue・PR・成果・承認は耐久的に保存し、作業台帳は失っても復元可能にする。
- 実行の証拠を残す。対象、担当、実行開始、終了、結果、検証したGitHubのHEADを最小限の記録で結び付ける。
- UNKNOWNを完了扱いしない。不明な作業と、実際に重なる資源のみ隔離する。独立性を証明できない作業は止める。
- 「修正済み」と「運用で動いた」を分ける。単体テスト、マージ、稼働環境の適用、実ワーカーの開始・完了、公開結果の再取得まで別々に検証する。
今回の教訓は、特定のDB製品の優劣ではありません。AIエージェントの長時間運用では、処理が消えたときの検知と、安全に仕事を続ける条件を先に設計することです。見栄えのよい進捗報告ではなく、実際の成果と実行証拠を残す。それが再発防止の中心になります。
記録の基準日:2026年10月11日(日本時間)。時刻・件数は当該プロジェクトの調査記録に基づきます。公開できない内部情報は省略しています。外部仕様参考:Python sqlite3、SQLite open flags、GitHub Actions concurrency。